Uydu görüntüsünde görsel-dil modelleri
Görsel-dil modelleri doğal fotoğraflarla eğitiliyor. Uydu görüntülerindeki soruları ne kadar doğru cevapladıklarını ve ince ayarın neyi değiştirdiğini ölçtük.
Soru
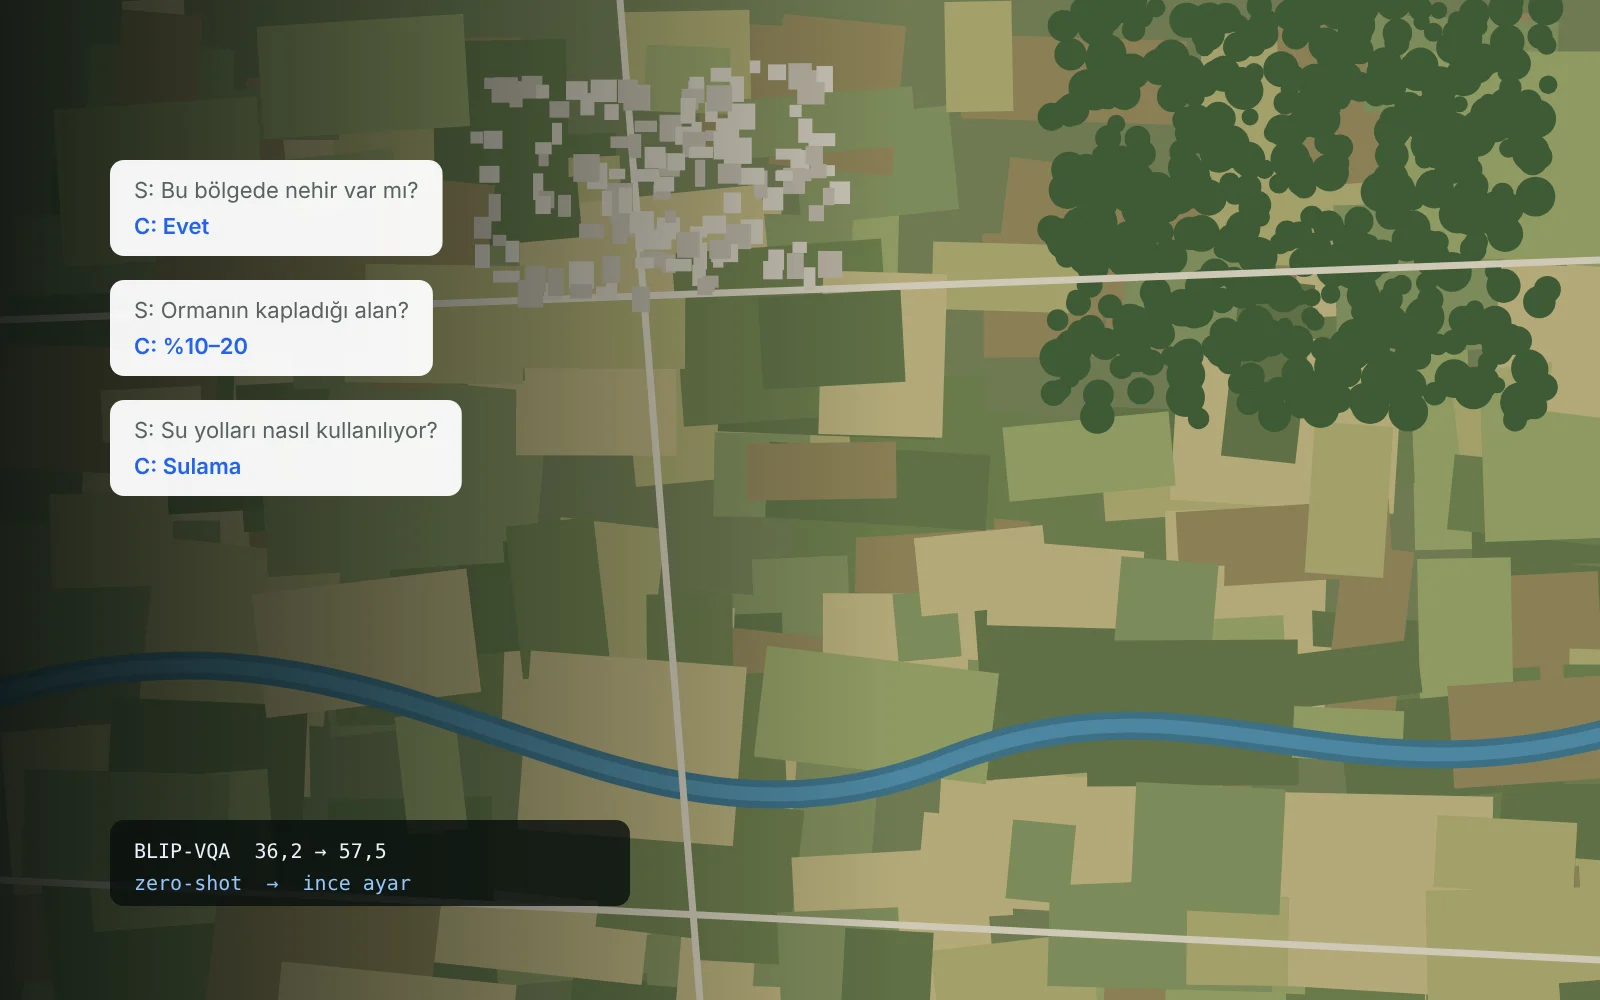
BLIP ve BLIP-2, uydu görüntüsü soru-cevap görevine ne kadar genellenebiliyor ve ince ayar, hangi soru türlerinde ne kadar fark yaratıyor?
Yöntem
İki modeli önce hiç eğitmeden (zero-shot), sonra EarthVQA üzerinde ince ayar yaparak test ettik. BLIP-2 modeline LoRA yöntemiyle ince ayar uyguladım. Yanıtların anlamsal uygunluğunu Sentence-BERT ve LLM-as-a-Judge yöntemleriyle de değerlendirdik.
Birebir eşleşme doğruluğu (%)
Değerlendirme
Sentence-BERT ve LLM-as-a-Judge, yanıtların anlamsal uygunluğunu da değerlendirmemizi sağladı.
Sonuç
İnce ayar, BLIP-VQA Base'de doğruluğu %36,23'ten %57,46'ya, BLIP-2'de %39,38'den %51,17'ye çıkardı. Nesne sayma ve birden fazla görsel ipucunu birlikte yorumlama soruları daha zor kalsa da çalışma, LoRA ile görsel-dil modellerinin uydu görüntülerine uyarlanabildiğini ve bu veri kümesindeki soruları yanıtlamak için kullanılabildiğini gösterdi. Harita yorumlama ve saha analizi uygulamaları için somut bir temel ortaya koydu.
Jetson Nano ile sahada veri seti üretimi →
Jetson Nano kamerasından görüntü yakalayıp YOLOE ve MobileSAM ile etiketleyen, insan onaylı veri seti üretim aracı.
Benzer bir proje mi düşünüyorsunuz?
15 dakikalık ön görüşmede problemi, veriyi ve en hızlı çözüm yolunu konuşalım. Genellikle aynı gün dönüş yaparım.